Overview
Two classification problems solved with SVMs: predicting whether a mushroom is edible or poisonous from its physical traits, and screening patients for diabetes risk from reported symptoms.
Key results
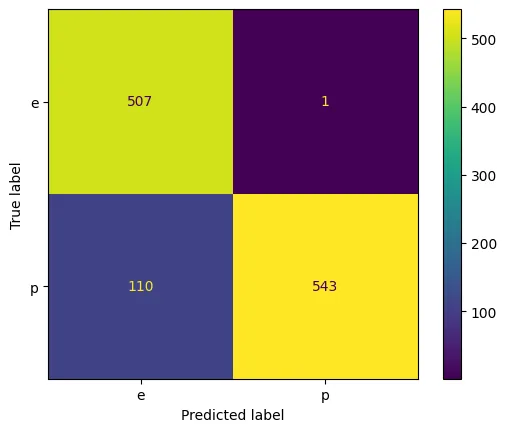
90.4%accuracy classifying 3,869 mushrooms as edible or poisonous
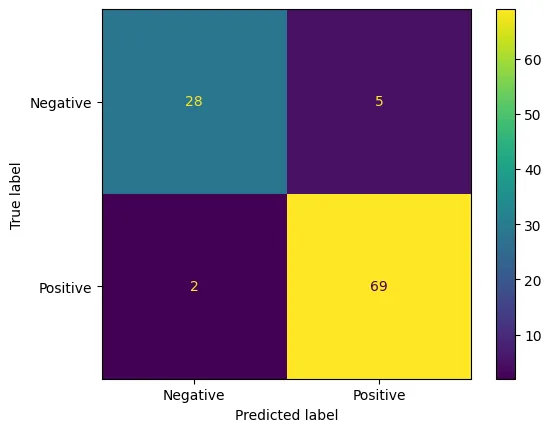
93.3%accuracy screening 520 patients for diabetes risk
The question
Can simple, observable features (cap shape, stem size and habitat, or symptoms like sudden weight loss) reliably predict a high-stakes outcome?
What I did
- Checked for missing values and data types, then encoded categories as dummy variables
- Scaled numeric features so no single measurement dominated the model
- Held out 30% of the data for testing and trained SVM classifiers
- Evaluated with accuracy, classification reports and confusion matrices
What I found
In both cases a wrong "safe" prediction is costly. Looking at the confusion matrix, not just accuracy, showed where each model made mistakes. That's the analysis a real business or clinic would need.
The Code
The actual Python I wrote for this project. Scroll inside the window to read it all.
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import pandas as pd
from sklearn.preprocessing import MinMaxScaler
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import classification_report
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay
#SVM 11/13/25 11/18/25
from sklearn import svm, datasets
from sklearn.svm import SVC
from itertools import product

#read data
df = pd.read_csv('mushroom.csv')
df.head(10)

mean_cap= 10
std_cap= 3
df['cap_width'] = np.random.normal(mean_cap, std_cap, 3869)
df.head()

df.isnull().sum()

len(df)

df.dtypes

#construct the features and label
features= df.iloc[:, 1:8]
features.head()

label= df.iloc[:, 0]
label.head()

df_dummy= pd.get_dummies(data=features, drop_first=True, dtype=int)
df_dummy.head()

#define Scalers
min_max_scaler= MinMaxScaler()

scaler= MinMaxScaler()
df_dummy[['stem_height', 'stem_width', 'cap_width']]= scaler.fit_transform(df_dummy[['stem_height', 'stem_width','cap_width']])
df_dummy.head()

#training and testing set , testing 30%
train_x, test_x, train_y, test_y= train_test_split(df_dummy, label, test_size=0.3, random_state=42)

classifier = SVC() #support vector machine
classifier.fit(train_x, train_y)

#use model to make preditions
predicted_y = classifier.predict(test_x)
predicted_y[0:5] #predicting first 5 rows of our data

#compare it to our real data
test_y[0:5]

#accuracy
acy = accuracy_score(test_y, predicted_y)
print(acy)

rp = classification_report(test_y, predicted_y)
print(rp)

#create confusion matrix for vizualization
cm = confusion_matrix(test_y, predicted_y, labels=classifier.classes_)
cmd = ConfusionMatrixDisplay(cm, display_labels=classifier.classes_)
cmd.plot()
plt.show()
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score
from sklearn.metrics import classification_report
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay
df = pd.read_csv('diabetes.csv')
df.head()
df.isnull().sum() #use to find missing values
df['result'].value_counts() #use to find if the data is evenly distributed
# set the features
features = df.iloc[:, 0:10]
features.head()
# set the dependant targets
label = df.iloc[:, -1]
label.head()
# dummy variables
dm_features = pd.get_dummies(features, drop_first=True, dtype=float)
dm_features.head()
# split the data into training and tesing
train_x, test_x, train_y, test_y = train_test_split(dm_features, label,
test_size=0.2, random_state=42) #train data size is .8
#model construction
classifier = SVC(kernel='rbf', gamma=1) #support vector machine with rbf kernel
classifier.fit(train_x, train_y)
#use model to make preditions
predicted_y = classifier.predict(test_x)
predicted_y[0:5] #predicting first 5 rows of our data
#compare it to our real data
test_y[0:5]
#prediction accuracy
acy = accuracy_score(test_y, predicted_y)
print(acy)
#classification report
rp = classification_report(test_y, predicted_y)
print(rp)
#create confusion matrix for vizualization
cm = confusion_matrix(test_y, predicted_y, labels=classifier.classes_)
cmd = ConfusionMatrixDisplay(cm, display_labels=classifier.classes_)
cmd.plot()
plt.show()
#convert to html
!jupyter nbconvert --to html bana410_hw2.ipynb